

En 30 segundos
- Las tres IAs aprueban con nota: ninguna baja de 9,7 sobre 10.
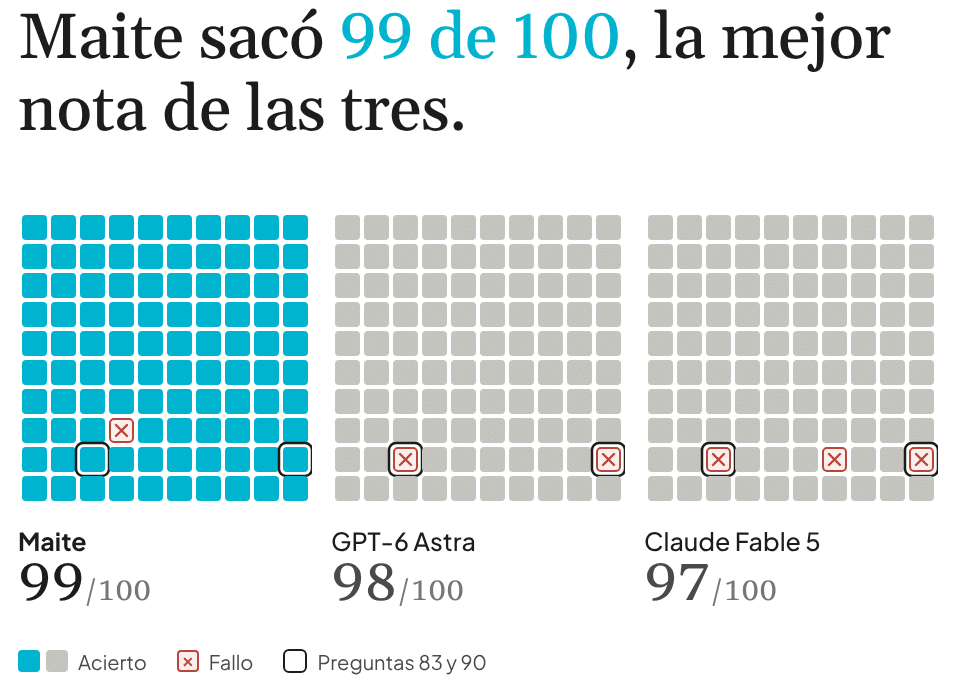
- En el test de judicatura, Maite sacó la nota más alta: 99 de 100.
- En el examen de acceso a la abogacía, GPT-6 Astra fue la mejor (98,8%) y Maite, segunda (98,2%).
- Sumando los dos exámenes, Maite y GPT-6 Astra empatan (98,5%); Claude Fable 5 se queda en el 97,4%.
- Maite acertó las 54 preguntas de materias comunes. Su punto débil es Penal (88,5%).
- GPT-6 Astra no está en la versión gratuita de ChatGPT, y Claude Fable 5 no está en el plan Pro de Claude.
Por qué lo hicimos
Cada vez más despachos nos hacen la misma pregunta: «¿Por qué Maite y no ChatGPT o Claude?». Responder con adjetivos es fácil. Preferimos medirlo con una prueba que cualquier jurista conoce bien: los exámenes que dan acceso a la profesión.
Elegimos dos. El examen de acceso a la abogacía 2026, que aprueba o suspende cada año a miles de graduados, y un test de 100 preguntas de oposiciones a judicatura, de los más exigentes que existen. Las mismas preguntas, las mismas instrucciones y la misma corrección para las tres IAs.
El resultado: las tres aprueban con nota
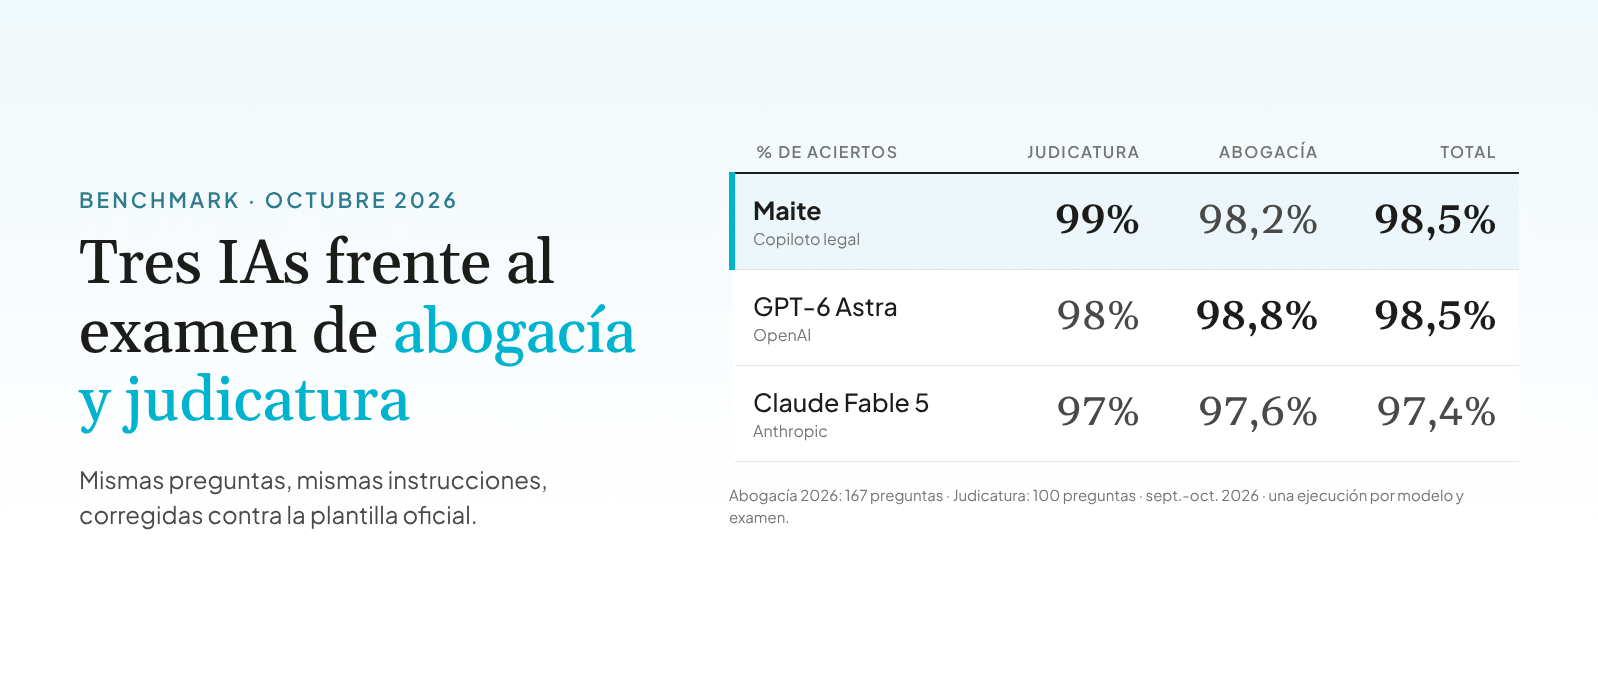
Ninguna IA baja de 9,7 sobre 10. En judicatura gana Maite; en abogacía, GPT-6 Astra. En el total, las dos empatan, y Claude Fable 5 queda algo por detrás en los dos exámenes.
| IA | Judicatura100 preguntas | Abogacía 2026167 preguntas | Total267 preguntas | Fallos |
|---|---|---|---|---|
| Maite – Omni | 99%99/100 · nota 9,90 | 98,2%163/166* · nota 9,82 | 98,5%262/266 | 4 |
| GPT-6 Astra | 98%98/100 · nota 9,80 | 98,8%165/167 · nota 9,88 | 98,5%263/267 | 4 |
| Claude Fable 5 | 97%97/100 · nota 9,70 | 97,6%163/167 · nota 9,76 | 97,4%260/267 | 7 |
* En la ejecución de Maite en abogacía, 1 pregunta se perdió por un error técnico de conexión y no se pudo evaluar. Su nota se calcula sobre 166 preguntas.
Con notas tan altas, lo que separa a una IA de otra son unas pocas preguntas. En todo el benchmark, Maite y GPT-6 Astra fallaron 4 cada una; Claude Fable 5, 7.
Maite: 4 fallos
GPT-6 Astra: 4 fallos
Claude Fable 5: 7 fallos
Judicatura: 99 de 100
En el test de judicatura, cada cuadrado es una pregunta. Maite falló una (la 74). GPT-6 Astra, dos (la 83 y 90) Claude Fable 5, tres (las 83, 87, 90)
Maite 99/100 — GPT-6 Astra 98/100 — Claude Fable 5 97/100
Las preguntas que marcan la diferencia
Lo más revelador no está en la nota, sino en cómo fallan. En las preguntas 83 y 90 del test de judicatura, GPT-6 Astra y Claude Fable 5 se equivocaron y, además, eligieron la misma respuesta incorrecta. Maite acertó las dos.
| Pregunta | Correcta | Maite | GPT-6 Astra | Claude Fable 5 |
|---|---|---|---|---|
| 74 | D | C✕ | D✓ | D✓ |
| 83 | C | C✓ | B✕ | B✕ |
| 87 | D | D✓ | D✓ | C✕ |
| 90 | C | C✓ | A✕ | A✕ |
Que dos modelos distintos coincidan en el mismo error sugiere que no es un despiste aleatorio: algo en el enunciado los lleva a la misma respuesta. Y la tabla también enseña lo contrario: en la pregunta 74, la única que se equivocó fue Maite. Ver el enunciado de las preguntas 83 y 90
Pregunta 83: La oferta vinculante confidencial como medio adecuado de solución de controversias (MASC):
a) Se puede revocar en cualquier momento.
b) Es irrevocable.
c) Se puede revocar en caso de no verse aceptada expresamente por la contraparte en el plazo que haya fijado quien la emite siempre que éste sea de al menos un mes.
d) Se puede revocar solamente en caso de haber sido rechazada por la contraparte en el plazo que haya fijado quien la emite siempre que éste sea de al menos un mes.
Pregunta 90: Indica la respuesta CORRECTA según regula el artículo 815 de la Ley de Enjuiciamiento Civil. La propuesta de requerimiento de pago planteada al peticionario por importe inferior al inicialmente solicitado en el proceso monitorio:
a) Ha de ser aceptada expresamente por el demandante para proceder a requerir de pago al demandado por dicha cantidad.
b) Podrá formularla el letrado de la Administración de Justicia si de la documentación aportada con la petición se desprende que la cantidad reclamada no es correcta.
c) Podrá plantearla el juez si, tratándose de una deuda fundada en un contrato celebrado entre un empresario y un consumidor, estimase que alguna de las cláusulas que constituye el fundamento de la petición pudiera ser calificada como abusiva.
d) Una vez aceptada por el peticionario, se entenderá como renuncia parcial a su pretensión.
Abogacía 2026: pleno en las materias comunes
El examen de acceso tiene un bloque de materias comunes, que hace cualquier aspirante, y cuatro especialidades. Nosotros pusimos a las tres IAs a responder todas.
| Bloque | Maite | GPT-6 Astra | Claude Fable 5 |
|---|---|---|---|
| Materias comunes al ejercicio de la abogacía 54 preguntas | 100%54/54 | 98,1%53/54 | 96,3%52/54 |
| Administrativo y contencioso-administrativo | 100% | 100% | 100% |
| Civil-mercantil | 100% | 100% | 100% |
| Laboral | 100% | 100% | 100% |
| Penal 27 preguntas | 88,5% (23/26) | 96,3% (26/27) | 92,6% (25/27) |
Maite acertó las 54 preguntas de materias comunes, la única de las tres en hacerlo. Las tres hicieron pleno en Administrativo, Civil-mercantil y Laboral.
Y donde no brillamos
En Penal, Maite fue la que más falló: 3 de las 26 preguntas que pudimos evaluar (88,5%), frente al 96,3% de GPT-6 Astra y el 92,6% de Claude Fable 5. Es el bloque en el que más margen de mejora tenemos, y lo estamos revisando.
Hubo también una pregunta, la 21 del examen de abogacía, que fallaron las tres IAs con la misma respuesta. Cuando todos los modelos coinciden en contra de la plantilla, conviene una segunda lectura: Las IAs están aquí para agilizar la práctica del derecho, pero nunca jamás para sustituir el criterio del profesional legal.
Qué cuesta tener ese nivel
El único modelo que empató con Maite es GPT-6 Astra, el modelo insignia de OpenAI. Conviene saber dónde está cada uno, porque «usar ChatGPT» o «usar Claude» puede significar modelos muy distintos según el plan.
| Plan | Precio al mes | ¿Incluye el modelo evaluado? | Uso |
|---|---|---|---|
| ChatGPT Free / Go | 0-8 € | No: usa GPT-6 Luna | Limitado |
| ChatGPT Plus | 23 € | Sí: GPT-6 Astra | Con límites de uso |
| ChatGPT Pro | desde 103 $ | Sí: GPT-6 Astra y su modo de razonamiento Pro | Modelo con límites |
| Claude Pro | 15€ | No: Claude Fable 5 solo con créditos de pago aparte | Limitado |
| Claude Max | 90 € | Sí: Claude Fable 5 | Hasta el 50% del límite semanal |
| Maite PRO | 125 € | Maite | Ilimitado |
Fuentes: ChatGPT, Claude y Maite. (08/10/2026) Los precios cambian a menudo; consulta la página de cada proveedor.
En resumen: si consultas dudas jurídicas a la versión gratuita de una IA generalista, no estás usando un modelo de este nivel. Para usar el modelo insignia sin límites, las generalistas piden sobre 100€ al mes, con uso limitado. Maite PRO cuesta 125 € al mes, sin límite de uso y hecha para derecho español.
Qué significa esto para tu despacho
Primero, el nivel ya no es el problema. Las mejores IAs aprueban los exámenes de acceso con nota. Lo que cambia entre ellas son unas pocas preguntas y, sobre todo, el modelo concreto que estás usando.
Segundo, un test es necesario, pero no suficiente. En el día a día importa también de dónde sale cada respuesta, poder comprobarla y trabajar con los documentos de cada asunto. Por eso Maite trabaja sobre documentación jurídica seleccionada en lugar de buscar en internet.
Y tercero, un 9,9 no sustituye tu criterio. Maite es tu copiloto, no el piloto. Lo que sí hace es darte una primera respuesta del nivel de los modelos insignia para que dediques tu tiempo a lo que solo tú puedes hacer.
Metodología
Queremos que cualquiera pueda entender, revisar y discutir estos resultados. Esto es exactamente lo que hicimos.
Los exámenes
Examen de acceso a la abogacía 2026. 167 preguntas tipo test con cuatro opciones: 54 de materias comunes al ejercicio de la profesión y las de las cuatro especialidades (administrativo y contencioso-administrativo, civil-mercantil, laboral y penal; 27 de penal). En el examen real cada aspirante responde las materias comunes y una sola especialidad; aquí las IAs respondieron todas. [confirmar convocatoria y origen de las preguntas y la plantilla]
Test de judicatura. 100 preguntas tipo test con cuatro opciones de oposiciones a las carreras judicial y fiscal.
Las IAs
| IA | Proveedor | Cómo se consultó | Fecha de la prueba |
|---|---|---|---|
| Maite | Maite | Configuración por defecto de Maite | Judicatura: 2 sept. · Abogacía: 3 sept. |
| GPT-6 Astra | OpenAI | API de OpenAI, modelo gpt-6-astra | Judicatura: 19 sept. · Abogacía: 8 oct. |
| Claude Fable 5 | Anthropic | API de Anthropic, modelo claude-fable-5 | Judicatura: 1 sept. · Abogacía: 2 sept. |
Las tres se evaluaron por separado entre el 1 de septiembre y el 8 de octubre de 2026. No comparamos versiones gratuitas ni modelos de gama media: elegimos un modelo de gama alta de cada proveedor.
Cómo preguntamos
Cada pregunta se envió por separado, con su enunciado y sus cuatro opciones, y con la misma instrucción para las tres IAs: responder con una sola letra.
Cómo corregimos
- Cada respuesta se comparó de forma automática con la plantilla oficial de respuestas.
- La nota es el porcentaje de aciertos sobre 10. No restamos por fallo; los exámenes reales pueden tener otras reglas de penalización.
- Ninguna IA dejó preguntas en blanco.
- Las preguntas perdidas por un error técnico de conexión no cuentan: solo ocurrió una vez, en la ejecución de Maite en abogacía, que se evalúa sobre 166 preguntas.
Cómo leer las diferencias
En judicatura, cada pregunta vale un punto porcentual; en abogacía, unos 0,6. Por eso las diferencias de una o dos preguntas no son estadísticamente significativas con una sola ejecución. Un ejemplo: en judicatura, Maite y GPT-6 Astra solo discrepan en 3 de las 100 preguntas (Maite acierta 2 de ellas y GPT-6 Astra, 1). Es una diferencia real, pero demasiado pequeña para afirmar que una sea mejor que otra en general.
Por eso hablamos de «mismo nivel» y de hechos concretos (99 de 100, 54 de 54, las preguntas 83 y 90), y no de rankings.
Limitaciones
- Una sola ejecución por IA y examen. Los modelos de lenguaje no siempre responden igual; repetir la prueba puede mover el resultado en una o dos preguntas.
- Un test no es el trabajo real. Mide conocimiento jurídico, no la calidad de un escrito, la búsqueda de jurisprudencia o el razonamiento sobre un caso.
- Versiones en movimiento. Las IAs cambian a menudo. Los resultados describen las versiones evaluadas en las fechas indicadas.
- Posible contaminación. No podemos descartar que alguna pregunta forme parte de los datos con los que se entrenaron los modelos.
- Lo hemos hecho nosotros. Maite es una de las IAs evaluadas. Por eso publicamos el método completo, incluidos los resultados en los que salimos peor.
Si quieres el detalle pregunta a pregunta, puedes contactarnos por email o por redes
Próximos pasos
Repetiremos el benchmark con cada nueva versión de Maite e incorporaremos nuevos modelos a medida que se publiquen.
Preguntas frecuentes
¿Qué IA saca mejor nota en el examen de acceso a la abogacía?
En nuestra prueba con el examen de 2026, GPT-6 Astra acertó el 98,8% de las preguntas, Maite el 98,2% y Claude Fable 5 el 97,6%. La diferencia entre las tres es de 1 a 2 preguntas sobre 167.
¿Y en el test de judicatura?
Maite sacó la nota más alta: 99 de 100. GPT-6 Astra acertó 98 y Claude Fable 5, 97.
¿La versión gratuita de ChatGPT da estos resultados?
No la hemos evaluado. El modelo que probamos, GPT-6 Astra, no está incluido en ChatGPT Free ni en Go, que usan GPT-6 Luna. Está en ChatGPT Plus (con límites de uso) y en Pro.
¿Por qué Maite falla más en Penal?
Falló 3 de las 26 preguntas de Penal que pudimos evaluar. Con tan pocas preguntas no podemos atribuirlo a una causa concreta; es el bloque en el que más margen de mejora tenemos y lo estamos revisando.
¿Basta con un examen tipo test para elegir una IA para el despacho?
No. Es una condición necesaria, no suficiente. En el trabajo real importan también las fuentes de cada respuesta, poder comprobarlas y trabajar con los documentos de cada asunto.
Pruébala con una pregunta de tu especialidad
La mejor forma de comparar es con tus propios casos.
Fuentes
- Benchmark interno de Maite: examen de acceso a la abogacía 2026 y test de judicatura, ejecuciones del 1 de septiembre al 8 de octubre de 2026.